15. MLIP와 기하 모델
이 장의 질문
원자 사이의 에너지와 힘을 예측하는 모형에는 어떤 대칭성과 검증이 필요할까?
기계학습 원자간 퍼텐셜(machine-learned interatomic potential, MLIP)은 원자 구조에서 에너지와 힘, 때로는 응력을 예측해 계산량이 큰 기준 계산을 근사한다. 학습된 퍼텐셜은 구조 최적화나 분자동역학(molecular dynamics, MD)에서 반복해 사용된다. 다음 흐름을 따라 각 단계의 역할을 살펴본다.
전체 흐름: 원자 기하 구조 → 대칭성을 반영한 표현 → 에너지 모형 → 힘 → 시뮬레이션 → 후속 검증
MLIP는 14장의 PDE 풀이 모형과 다른 문제를 다룬다. 둘 다 AI4Science에 속하지만 입력과 출력, 사전 지식, 기준 데이터, 실패 양상이 다르다.
읽기 수준과 선수지식 확인
읽기 전에 확인할 내용
- 원자와 화학종: 원소의 종류와 위치가 원자 구조를 이룬다.
- 좌표, 거리, 각도: 3차원 기하 구조를 나타낸다.
- 에너지: 구조의 상대적 안정성과 동역학을 결정하는 스칼라 물리량이다.
- 힘: 원자 좌표에 따른 에너지 변화와 연결되는 벡터 물리량이다.
- 주기적 경계조건: 결정이나 벌크 계를 반복 단위 셀로 나타낸다.
- 그래프와 메시지 전달: 8장에서 배운 노드, 에지, 이웃의 개념을 사용한다.
- 불변성과 등변성: 변환해도 같아야 하는 값과 입력 변환에 맞춰 함께 변해야 하는 값을 구분한다.
밀도범함수이론(density functional theory, DFT)의 세부 이론까지 알 필요는 없다. 원자 구조의 기준 에너지와 힘을 계산하는 데 널리 쓰이는 전자 구조 방법이라는 점만 알아두면 된다.
1. 퍼텐셜 에너지 곡면을 근사한다
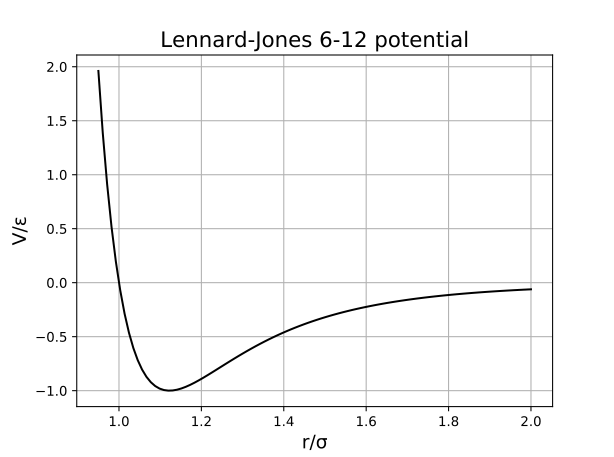
\(N\)개 원자의 화학종을 \(Z=(Z_1,\dots,Z_N)\), 좌표를 \(R=(r_1,\dots,r_N)\)이라고 하자. 퍼텐셜 에너지 표면(potential energy surface, PES)는 구조에 에너지를 대응시킨다.
힘은 에너지의 좌표 기울기와 연결된다.
MLIP는 기준 계산으로 얻은 구조-에너지-힘 쌍을 사용해 \(E_\theta(Z,R)\)를 학습한다. 힘을 에너지 기울기로 계산하면 스칼라 에너지와 벡터 힘 사이의 일관성을 구조적으로 만들 수 있다.
이 관계는 자동미분이 과학 모델에 사용되는 또 다른 예다. PINN은 좌표 도함수로 PDE 잔차를 만들었고, MLIP는 예측 에너지의 좌표 도함수로 힘을 얻는다.

2. 왜 원자간 퍼텐셜을 학습하는가
높은 정확도의 전자 구조 계산은 계의 크기와 필요한 샘플링 양에 따라 많은 계산비용이 들 수 있다. 반면 MD는 아주 많은 시간 단계에서 힘을 반복 평가해야 한다. MLIP는 기준 방법의 PES를 근사해 더 큰 계나 더 긴 궤적을 탐색하려 한다.
여기서 빠르다는 주장은 조건을 포함해야 한다.
- 어떤 기준 방법과 비교하는가
- 같은 하드웨어와 정밀도 조건인가
- 이웃 구성과 통신 비용을 포함했는가
- 훈련 데이터 생성과 모형 훈련 비용을 포함했는가
- 원하는 후속 정확도와 안정성을 유지하는가
MLIP는 기준 방법보다 빠를 수 있지만 모형을 학습한 분포 안에서 기준 방법을 근사하는 것이다. 자연의 정확한 퍼텐셜을 직접 얻는 것은 아니다.
3. 입력 구조가 만족해야 하는 대칭성
고립된 계의 전체 에너지는 좌표 계를 평행 이동하거나 회전해도 변하지 않아야 한다. 같은 화학종의 원자 색인을 바꾸어도 물리적 구조는 같다.
- 이동 불변성: 모든 원자를 같은 벡터만큼 옮겨도 에너지가 같다.
- 회전 불변성: 구조 전체를 회전해도 에너지가 같다.
- 순열 불변성: 동일 화학종 원자의 순서를 바꾸어도 전체 에너지가 같다.
힘은 벡터이므로 회전에 대해 불변이 아니라 등변해야 한다. 구조를 회전 \(Q\)로 돌리면 힘도 같은 방식으로 회전해야 한다.
이 성질은 데이터 증강만으로 근사할 수도 있지만 구조 표현자나 모형 구조에 직접 넣으면 데이터 효율성과 일관성에 도움이 될 수 있다. 그래도 등변성이 예측 정확도나 OOD 일반화를 자동으로 보장하지는 않는다.
4. 국소 에너지 분해와 컷오프 반지름
많은 MLIP는 전체 에너지를 원자 기여분의 합으로 표현한다.
\(\mathcal{N}_i\)는 절단 반경 안의 국소 환경이다. 이 표현은 전체 에너지의 크기 가산적 성질과 크기가 다양한 계를 다루기 쉽게 한다. 또한 이웃 목록을 사용하면 계산량을 제어할 수 있다.
하지만 실제 상호작용이 모두 짧은 거리는 아니다. 정전기 상호작용, 분산력, 전하 이동 같은 장거리 효과를 국소 절단만으로 충분히 표현하지 못할 수 있다. 메시지 전달 층을 여러 번 쌓아 수용 영역을 늘릴 수 있지만 계산량과 과도한 평활화 문제가 생길 수 있다. 명시적 장거리 항, 전하 모형, 전역 상호작용을 결합하는 이유다.
국소성은 편리한 공학적 선택이자 물리적 가정이다. 대상 계와 물성에 맞는지 검증해야 한다.
핵심 흐름 펼쳐보기: 표현, 데이터 구성, 시뮬레이션 검증
5. 서술자 기반 모형에서 학습된 표현으로
초기 신경망 퍼텐셜의 대표 사례인 Behler-Parrinello 모형은 각 원자 주변의 기하 구조를 대칭성 함수로 표현하고 원자 신경망으로 에너지 기여분을 예측한다. 구조 표현자가 이동, 회전, 순열 성질을 반영하도록 설계된다.
SchNet은 원자 사이 거리에 대한 연속 필터 합성곱을 사용해 원자 표현을 학습한다. 이는 사람이 정한 고정 구조 표현자에서 종단간 학습된 표현으로 이동한 중요한 예다.
입문 단계의 핵심 구분은 다음과 같다.
- 수작업으로 설계한 구조 표현자는 어떤 기하학적 물리량을 모형에 줄지 사람이 결정한다.
- 불변 메시지 전달은 거리 같은 불변 특성을 사용해 표현을 학습한다.
- 등변 모형은 스칼라뿐 아니라 벡터나 고차 기하학적 특성이 회전에 맞춰 변하도록 층을 구성한다.
이 셋은 단순한 성능 순위가 아니다. 데이터 양, 화학적 다양성, 목표 정확도, 추론 비용, 소프트웨어 생태계에 따라 선택이 달라진다.
6. 등변 메시지 전달
3차원 등변 GNN은 상대 위치의 방향 정보를 보존하면서 메시지를 전달한다. 특성은 회전에 변하지 않는 스칼라만 있을 수도 있고, 회전에 맞춰 변하는 벡터나 텐서 표현을 포함할 수도 있다.
NequIP은 E(3)-등변 합성곱과 메시지 전달을 이용하는 대표적인 모형 구조다. MACE는 고차 메시지와 등변 표현을 효율적으로 구성하는 계열이다. 모델별 수학과 구현 차이는 후속 심화 주제로 남긴다.
이름보다 다음 질문이 중요하다.
- 에너지 출력이 회전과 순열에 불변한가
- 힘은 에너지 기울기로 얻는가, 별도 헤드로 예측하는가
- 어떤 상호작용 차수와 각도 정보를 표현하는가
- 절단과 메시지 전달 깊이가 유효 수용 영역을 어떻게 정하는가
- 계산 정밀도와 이웃 수가 비용에 어떤 영향을 주는가
7. 에너지, 힘, 응력을 함께 학습하기
훈련 손실은 에너지와 힘 오차의 가중합으로 구성할 수 있다.
한 구조에는 에너지 레이블 하나와 원자 수에 비례한 힘 성분이 있다. 단순히 모든 성분을 합하면 힘 항이 손실을 지배할 수 있다. 원자당 정규화, 단위, 가중치, 데이터셋 조성을 함께 봐야 한다.
힘 레이블은 PES의 국소 기울기 정보를 제공하므로 데이터 효율성에 도움이 될 수 있다. 하지만 기준 힘도 수렴 오차를 가지며, 에너지와 힘을 함께 맞추는 최적화가 자동으로 쉽지는 않다. 에너지, 힘, 응력 평가 지표를 별도로 보고 후속 결과까지 확인한다.
8. 기준 데이터가 모형의 적용 범위를 정한다
훈련 데이터에는 모형이 시뮬레이션 중 만날 관련 있는 구성이 포함되어야 한다. 평형 구조만 학습하면 높은 온도, 결함, 전이 상태, 충돌처럼 평형에서 먼 구성에서 실패할 수 있다.
데이터 설계 시 다음 축을 기록한다.
- 화학적 화학종과 조성
- 결정 상, 분자 입체 구조, 결함
- 부피, 변형률, 온도, 압력
- 에너지와 힘의 범위
- 기준 방법, 기저, 유사퍼텐셜, 수렴 기준
- 샘플링 방법과 중복 제거 방식
무작위 구조 분할은 거의 같은 궤적의 이웃 프레임을 훈련과 테스트에 나눌 수 있다. 이 경우 테스트 오차가 낮아도 새로운 궤적이나 상에 일반화한다고 볼 수 없다. 궤적, 조성, 원형, 열역학 조건에 따른 분할을 사용 목적에 맞게 설계한다.
9. 능동 학습과 불확실성의 위치
처음부터 모든 가능한 구성을 기준 계산으로 만들 수는 없다. 능동 학습은 현재 모형이 불확실하거나 위원회 모형 예측이 크게 엇갈리는 구성을 선택해 기준 레이블을 추가하는 반복 작업 흐름이다.
- 초기 데이터셋으로 모형 또는 앙상블을 학습한다.
- 모형으로 구조 탐색이나 MD를 수행한다.
- 불확실하거나 새로운 구성을 선택한다.
- 기준 계산을 수행해 데이터셋에 추가한다.
- 모형을 다시 학습하고 검증한다.
불확실성 스코어가 실제 오차와 항상 일치하는 것은 아니다. 선택 편향과 사각지대가 남을 수 있으므로 독립적인 테스트 데이터, 물리적 타당성 점검, 실패 복구가 필요하다. 능동 학습은 자동으로 안전한 포괄성을 보장하는 버튼이 아니라 데이터셋 구성 전략이다.
10. 후속 시뮬레이션으로 검증하기
에너지 MAE나 힘 RMSE는 필요하지만 충분하지 않다. 작은 개별 예측 오차도 MD에서 반복되며 궤적과 열역학 물성에 영향을 줄 수 있다.
평가를 다음 층으로 확장한다.
- 지점 예측: 에너지, 힘, 응력 오차와 오차 분포
- 구조 최적화: 이완된 기하 구조, 격자 매개변수, 상대 안정성
- 응답과 동역학: 상태방정식, 포논, 장벽, 진동 물리량
- MD 거동: 에너지 표류, 온도 분포, 궤적 안정성
- 열역학 또는 동역학 목표량: 연구 질문에 맞는 관측량
- OOD 응력 테스트: 새로운 상, 조성, 결함, 온도, 압력
- 효율성: 원자-단계당 시간, 메모리, 크기 조정, 기준 데이터 비용
모든 후속 물성을 한 연구에서 다 측정할 필요는 없다. 실제 사용 목적에 직접 연결된 테스트를 미리 정하는 것이 중요하다.
11. MLIP와 다른 모델을 구분하기
- 분자 물성 예측기는 한 구조의 레이블을 예측할 수 있지만 MD에 필요한 보존적 힘장을 제공하지 않을 수 있다.
- 생성 모형은 새로운 구조 후보를 만들 수 있지만 그 에너지와 동역학을 정확히 평가하는 퍼텐셜은 아닐 수 있다.
- 신경 연산자는 함수-함수 사상을 학습하며 원자 PES를 학습하는 MLIP와 입출력 구조가 다르다.
- 고전적 힘장은 매개변수화된 물리 함수 형태를 사용하고, MLIP는 더 유연한 학습된 표현을 사용한다. 둘 모두 적용 범위와 검증이 필요하다.
현대 작업 흐름은 생성 모델로 후보를 만들고 MLIP로 탐색한 뒤 높은 정확도의 계산과 실험으로 검증할 수 있다. 각 성분의 역할과 오차를 분리해야 한다.
이 장에서 기억할 내용
- MLIP는 원자 구조에서 기준 에너지와 힘을 근사하는 학습된 퍼텐셜이다.
- 스칼라 에너지는 강체 변환과 동일 원자 순열에 불변해야 하고, 벡터 힘은 회전에 등변해야 한다.
- 힘을 에너지 기울기로 계산하면 에너지-힘 일관성을 구조적으로 만들 수 있다.
- 국소 절단, 훈련 분포, 기준 방법이 적용 범위를 제한한다.
- 점별 오차뿐 아니라 실제 구조 이완, 동역학, 물성, OOD 조건으로 검증해야 한다.
이름과 위치만 알아둘 내용
- Behler-Parrinello 대칭성 함수
- SchNet과 연속 필터 합성곱
- NequIP과 E(3)-등변 메시지 전달
- MACE와 고차 등변 표현
- 장거리 정전기 상호작용과 전하 인식 퍼텐셜
- 델타 학습과 다중 충실도 데이터
- 능동 학습과 위원회 모형 불확실성
자주 하는 혼동과 한계
자주 생기는 혼동과 한계
DFT 데이터로 학습하면 DFT와 항상 같은가
아니다. 유한한 데이터셋과 모형 용량 때문에 근사 오차가 있고, 훈련 분포 밖에서는 오차가 커질 수 있다. 기준 DFT 자체도 선택한 근사와 수치 설정에 의존한다.
힘 오차가 작으면 MD가 안정적인가
보장되지 않는다. 드문 구성의 큰 오차, 비보존적 힘, 적분 설정이 궤적을 망칠 수 있다. 장기 롤아웃과 목표 관측량을 검증해야 한다.
등변성이 OOD 일반화를 해결하는가
아니다. 좌표계 변환에 대한 올바른 거동을 보장하거나 유도하지만, 보지 못한 화학 조성, 상, 열역학 조건의 정확성을 보장하지 않는다.
큰 범용 모형이면 모든 시뮬레이션에 바로 쓸 수 있는가
아니다. 대상 계, 조성, 전하 상태, 압력과 온도 범위에 대한 검증이 필요하다. 미세 조정을 하더라도 치명적 실패 영역을 별도로 탐색해야 한다.
낮은 테스트 MAE면 과학 결론이 신뢰할 만한가
아니다. 상대적 상 안정성 순서, 장벽, 포논, MD 안정성처럼 실제 결론을 결정하는 후속 물리량을 확인해야 한다.
AI4Science 종합 연결
자동미분 + 복합 손실 -> PINN합성곱 + 함수 표현 -> 신경 연산자GNN + 3차원 기하 구조 + 등변성 -> MLIP생성 모형 -> 새로운 과학 후보의 분포RL -> 순차 제어와 실험 선택기준 모델 + 데이터 분할 + OOD + 전체 비용 -> 모든 접근의 과학적 평가
PINN, 신경 연산자, MLIP는 하나의 발전 계보가 아니다. 서로 다른 입력, 출력, 사전 지식, 학습 신호를 1장에서 제시한 다섯 질문으로 비교한다.
스스로 확인하기
- 원자 구조를 회전할 때 에너지와 힘은 각각 불변과 등변 중 어떤 성질을 가져야 하는가?
- 작은 에너지 또는 힘 테스트 오차와 안정적인 MD 궤적이 같은 평가가 아닌 이유는 무엇인가?
- 국소 절단이 계산에는 유리하지만 장거리 상호작용에는 한계가 될 수 있는 이유는 무엇인가?
- MLIP와 분자 물성 예측기, 구조 생성 모형의 입출력 역할은 어떻게 다른가?
더 읽을 자료
- Behler and Parrinello, Generalized Neural-Network Representation of High-Dimensional Potential-Energy Surfaces, Physical Review Letters 2007: https://doi.org/10.1103/PhysRevLett.98.146401
- Schütt et al., SchNet: A continuous-filter convolutional neural network for modeling quantum interactions, NeurIPS 2017: https://papers.nips.cc/paper/6700-schnet-a-continuous-filter-convolutional-neural-network-for-modeling-quantum-interactions
- Batzner et al., E(3)-equivariant graph neural networks for data-efficient and accurate interatomic potentials, Nature Communications 2022: https://doi.org/10.1038/s41467-022-29939-5
- Batatia et al., MACE: Higher Order Equivariant Message Passing Neural Networks for Fast and Accurate Force Fields, NeurIPS 2022: https://openreview.net/forum?id=YPpSngE-ZU
- Deringer, Caro, and Csányi, Machine Learning Interatomic Potentials as Emerging Tools for Materials Science, Advanced Materials 2019: https://doi.org/10.1002/adma.201902765
원전을 읽을 때 벤치마크 순위보다 기준 데이터의 화학 조성과 구성 범위, 에너지-힘 손실, 분할, 후속 검증, 계산비용을 먼저 확인한다.