9. 생성 모델과 VAE
이 장의 질문
잠재 공간에서 임의로 뽑은 값으로 그럴듯한 새 샘플을 만들려면 무엇이 필요할까?
분류와 회귀는 주어진 입력의 목표값을 예측한다. 생성 모델은 데이터가 만들어지는 분포를 학습해 그 분포를 닮은 새 샘플을 만든다. 변분 오토인코더(Variational Autoencoder, VAE)는 관측 데이터 뒤에 직접 보이지 않는 잠재 변수가 있다고 가정하고 인코더와 디코더를 확률 모형으로 연결한다. 일반 오토인코더의 잠재 공간에서 임의 추출이 어려운 이유, 사전 분포와 사후 분포의 역할, ELBO가 복원과 분포 규제를 함께 다루는 방식을 알아본다.
읽기 수준과 선수지식 확인
읽기 전에 확인할 내용
- 4장의 PCA, 오토인코더, 인코더, 병목, 디코더
- 확률분포와 조건부확률
- 기댓값과 로그 가능도의 의미
- 가우스 분포의 평균과 분산
- 2장의 역전파와 기울기 기반 학습
KL 발산과 변분추론의 계산을 처음부터 따라갈 필요는 없다. 두 분포의 차이를 재고 계산하기 어려운 사후 분포를 근사한다는 역할을 이해하면 된다.
1. 생성 모델은 무엇을 학습하는가
관측 데이터 \(x\)가 어떤 미지의 데이터 분포에서 왔다고 하자. 생성 모델은 그 분포 자체 \(p(x)\) 또는 샘플을 만드는 절차를 학습하려 한다.
생성 모델은 하나의 계보가 아니라 서로 다른 문제 설정을 가진 여러 계열이다.
- 자기회귀 모형은 이미 생성한 값에 조건부로 다음 값을 차례로 생성한다.
- 생성 적대 신경망(GAN)은 생성기와 판별기의 경쟁으로 데이터와 닮은 샘플을 만든다.
- 잠재 변수 모형과 VAE는 잠재 변수와 관측 데이터의 확률 관계를 학습한다.
- 확산과 스코어 기반 모형은 노이즈를 추가한 뒤 제거하는 과정을 학습한다.
- 정규화 흐름과 플로 매칭은 간단한 분포와 데이터 분포 사이의 변환이나 벡터장을 학습한다.
이 과정은 VAE, 확산, 플로 매칭을 선택해 살펴본다. 세 방법이 생성 모델 전체이거나 단순한 발전 순서라는 뜻은 아니다.
조건부 생성
생성에 레이블, 텍스트, 물성값 같은 조건 \(c\)를 주면 \(p(x \mid c)\)를 다루는 조건부 생성이 된다. 조건을 만족하는지와 샘플이 실제 데이터처럼 보이는지는 서로 다른 평가 문제다.
2. 오토인코더는 압축과 복원을 학습한다
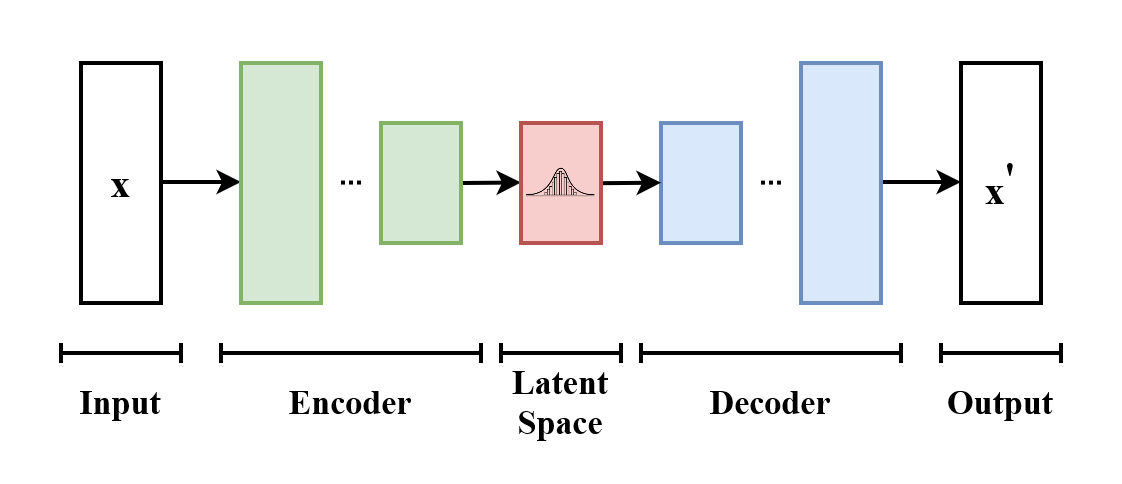
일반 오토인코더(AE)는 인코더 \(f_\phi\)가 입력 \(x\)를 잠재 코드 \(z\)로 압축하고, 디코더 \(g_\theta\)가 이를 다시 \(\hat{x}\)로 복원한다.
학습은 입력과 복원 결과의 차이인 복원 손실을 줄인다. 병목이 충분히 제한되어 있으면 입력의 중요한 구조를 잠재 표현에 담도록 유도할 수 있다.
그러나 복원이 잘된다는 사실만으로 생성 가능한 잠재 공간이 생기는 것은 아니다. 인코더가 훈련 샘플을 잠재 공간의 서로 떨어진 영역에 배치할 수 있고, 샘플 사이의 빈 공간을 임의로 고르면 디코더가 본 적 없는 비현실적인 결과를 낼 수 있다. 일반 AE에는 어디에서 z를 뽑아야 하는가를 정하는 명시적인 확률 분포가 없다.
특정 조건의 선형 오토인코더는 PCA와 같은 주요 부분공간을 학습할 수 있다. 하지만 비선형 AE, 규제된 AE, VAE 전체가 PCA와 같은 방법인 것은 아니다.

3. 잠재 변수 모형의 관점
VAE는 관측되지 않은 잠재 변수 \(z\)가 먼저 생성되고, 그로부터 데이터 \(x\)가 만들어진다고 가정한다.
여기서 세 분포를 구분해야 한다.
- 사전 분포 \(p(z)\)는 데이터를 보기 전에 잠재 변수가 따르는 분포다. 보통 계산과 샘플링이 쉬운 표준 가우스 분포를 사용한다.
- 가능도 \(p_\theta(x \mid z)\)는 주어진 잠재 \(z\)에서 데이터 \(x\)가 생성될 분포를 디코더가 나타낸 것이다.
- 사후 분포 \(p_\theta(z \mid x)\)는 관측된 \(x\)가 주어졌을 때 어떤 \(z\)가 원인이었을지 나타내는 분포다.
새 샘플을 만들 때는 사전 분포에서 \(z\)를 뽑고 디코더를 통과시킨다. 따라서 훈련 데이터의 인코딩이 사전 분포와 전혀 다른 영역에만 모이면 사전 분포 샘플링이 제대로 작동하기 어렵다.
핵심 흐름 펼쳐보기: ELBO와 재매개변수화
4. 계산하기 어려운 사후 분포를 근사하기
정확한 사후 분포는 베이즈 규칙으로 쓸 수 있다.
문제는 분모의 주변 가능도 \(p_\theta(x)=\int p_\theta(x \mid z)p(z)\,dz\)가 복잡한 신경망 디코더에서 보통 직접 계산하기 어렵다는 점이다.
VAE는 인코더 \(q_\phi(z \mid x)\)를 두어 실제 사후 분포를 근사한다. 이를 상각 변분추론(amortized variational inference)이라고 부른다. 각 데이터 지점마다 별도의 최적화를 하는 대신 하나의 인코더가 입력에서 근사 사후 분포의 매개변수를 출력하기 때문이다.
대표적으로 인코더는 가우스의 평균 \(\mu_\phi(x)\)와 분산 또는 로그 분산을 출력한다.
5. ELBO는 두 목표를 연결한다
VAE는 로그 가능도 자체 대신 계산 가능한 하한인 증거 하한(evidence lower bound, ELBO)를 최대화한다.
두 항의 역할을 분리해서 읽는 것이 중요하다.
- 첫 항은 추출한 잠재에서 원래 \(x\)를 잘 설명하거나 복원하도록 한다.
- 두 번째 KL 항은 각 입력의 근사 사후 분포가 사전 분포에서 지나치게 벗어나지 않도록 조절한다.
손실을 최소화하는 관례로 쓰면 복원 손실에 KL 규제를 더한 형태로 보인다. 두 목표는 긴장 관계가 있다. 복원만 강조하면 훈련 샘플은 잘 복원해도 잠재 공간이 사전 분포와 맞지 않을 수 있다. KL만 지나치게 강조하면 잠재가 입력 정보를 충분히 담지 않을 수 있다.
ELBO는 단순히 좋은 잠재 공간을 만드는 손실이 아니다. 데이터 가능도의 하한이자 근사 사후 분포와 실제 사후 분포의 차이를 다루는 변분추론 목적 함수다.
6. 재매개변수화로 기울기를 전달한다
인코더가 만든 분포에서 \(z\)를 그대로 샘플링하면 샘플링 연산을 통해 인코더 매개변수로 기울기를 보내기 어렵다. 가우스 근사 사후 분포에서는 다음처럼 무작위성과 매개변수 의존성을 분리한다.
무작위성은 \(\epsilon\)에 두고, \(\mu\)와 \(\sigma\)는 미분 가능한 계산으로 남긴다. 이를 재매개변수화 기법이라고 한다. 그래서 몬테카를로 샘플을 사용하면서도 역전파로 인코더와 디코더를 함께 학습할 수 있다.
7. 학습, 복원, 생성을 구분하기
VAE를 사용할 때 세 경로를 구분하면 혼동이 줄어든다.
- 훈련: 입력 \(x\)에서 \(q_\phi(z \mid x)\)의 매개변수를 구하고 \(z\)를 샘플한 뒤, 복원과 KL 항으로 인코더와 디코더를 갱신한다.
- 복원: 주어진 \(x\)를 인코더와 디코더에 통과시켜 비슷한 \(\hat{x}\)를 만든다.
- 생성: 입력 데이터 없이 사전 분포 \(p(z)\)에서 \(z\)를 샘플하고 디코더로 새로운 \(x\)를 만든다.
두 잠재 지점 사이를 잇는 보간은 표현의 연속성을 탐색하는 방법이다. 중간 결과가 자연스럽다고 해서 각 잠재 차원이 사람이 이름 붙인 독립 요인을 의미하는 것은 아니다.
8. 대표적 실패와 절충 관계
사후 붕괴(posterior collapse)는 근사 사후 분포가 사전 분포와 거의 같아지고 디코더가 \(z\)를 충분히 사용하지 않는 현상이다. 강력한 자기회귀 디코더가 잠재 정보 없이도 데이터를 잘 예측할 때 나타날 수 있다. KL 어닐링이나 디코더 조절 등 여러 완화 방법이 있지만 일반적인 해결책 하나가 있는 것은 아니다.
VAE의 가능도 모형 선택도 중요하다. 픽셀 값을 베르누이로 볼지 가우스로 볼지, 분산을 고정할지 학습할지에 따라 복원 항의 의미가 달라진다. 흔히 쓰는 평균제곱오차는 특정 가우스 가능도 가정과 연결되며 단순한 편의 이상의 모델링 선택이다.
이 장에서 기억할 내용
꼭 이해할 내용
- 일반 AE의 복원 목적과 임의 샘플링의 한계
- 사전 분포, 가능도, 사후 분포, 근사 사후 분포의 역할
- ELBO의 복원 항과 KL 항
- 재매개변수화가 샘플링과 역전파를 연결하는 방식
- 훈련, 복원, 사전 분포 샘플링의 차이
다음 공부를 위해 알아둘 내용
- 변분 추론과 상각 추론
- KL 발산의 정확한 유도
- 조건부 VAE
- 사후 붕괴
- 요인이 분리된 표현과 \(\beta\)-VAE
- 자기회귀 모형, GAN, 정규화 흐름
자주 하는 혼동과 한계
자주 생기는 혼동과 한계
VAE는 차원 축소 시각화 도구와 같지 않다
VAE의 잠재 차원을 2로 두어 그릴 수는 있지만, PCA나 t-SNE처럼 시각화 자체가 주목적인 방법은 아니다. 목적 함수와 가정이 다르다.
매끄러운 보간은 의미 분리의 증명이 아니다
잠재 보간이 자연스러워 보여도 각 차원이 독립적이고 해석 가능한 원인을 나타낸다고 단정할 수 없다.
- 사전 분포가 실제 잠재 구조에 비해 지나치게 단순할 수 있다.
- ELBO가 높아지는 것과 사람이 선호하는 샘플 품질이 항상 일치하지 않는다.
- 복원 품질과 생성 품질은 다른 평가다.
- 생성된 샘플의 다양성과 훈련 샘플 암기를 별도로 확인해야 한다.
- 과학 데이터에서는 유효성 제약과 후속 시뮬레이션 검증이 필요할 수 있다.
다섯 질문으로 다시 보기
- 입력과 출력: 학습 중 데이터 \(x\)를 받아 잠재 분포의 매개변수와 복원을 만들고, 생성 시 사전 분포 샘플에서 새 데이터를 만든다.
- 구조적 가정: 관측 데이터가 낮은 차원의 잠재 변수에서 확률적으로 생성된다고 가정한다.
- 학습 신호: 복원 로그 가능도와 KL 규제로 구성된 ELBO를 사용한다.
- 기준 모델: PCA, 결정론적 AE, 단순 밀도 모형과 비교 목적을 명확히 한다.
- 평가: 복원, 샘플 품질, 다양성, 조건부 충실도, 가능도 관련 지표를 구분한다.
- 실패 조건: 사후 붕괴, 사전 분포 불일치, 디코더 오지정, 데이터 암기를 점검한다.
앞뒤 장과의 연결
4장의 차원 축소와 AE가 표현을 압축했다면, VAE는 잠재 공간에 확률적 생성 규칙을 더한다. 10장의 확산은 하나의 잠재 병목에서 복원하는 대신 여러 노이즈 수준에서 노이즈 제거를 학습한다. 11장의 플로 매칭은 출발 분포에서 목표 분포로 이동하는 벡터장을 직접 학습한다.
스스로 확인하기
- 결정론적 AE에서 복원이 잘되어도 사전 분포 샘플링이 어려울 수 있는 이유는 무엇인가?
- 사전 분포, 사후 분포, 근사 사후 분포는 각각 언제 어떤 정보를 나타내는가?
- ELBO의 복원 항과 KL 항은 어떤 긴장 관계를 만드는가?
- 복원과 생성은 입력 \(x\)의 사용 여부가 어떻게 다른가?
더 읽을 자료
- Kingma and Welling, Auto-Encoding Variational Bayes, 2014. VAE와 재매개변수화의 대표 원 논문
- Rezende, Mohamed, and Wierstra, Stochastic Backpropagation and Approximate Inference in Deep Generative Models, 2014. 동시기에 제안된 확률적 역전파 연구
- Higgins et al., beta-VAE: Learning Basic Visual Concepts with a Constrained Variational Framework, 2017. 잠재 표현 규제를 조절한 대표 사례
- Goodfellow et al., Generative Adversarial Nets, 2014. 생성 모델 계열에서 GAN의 위치를 확인할 1차 자료