2. 신경망과 역전파
이 장의 질문
신경망은 예측 오차로부터 각 매개변수의 수정 방향을 어떻게 구할까?
신경망 학습에는 두 종류의 계산이 반복된다. 순전파는 현재 매개변수로 예측을 만들고, 역전파는 예측에서 계산한 손실을 이용해 각 매개변수의 기울기를 구한다. 옵티마이저는 그 기울기를 받아 매개변수를 갱신한다. 이 세 역할을 분리해 이해하면 딥러닝 학습 과정의 대부분을 읽을 수 있다.
읽기 수준과 선수지식 확인
읽기 전에 확인할 내용
핵심 개념
- 선형 모형, 로지스틱 모형, 다층 퍼셉트론(multilayer perceptron, MLP)
- 가중치, 편향, 활성화 함수
- 순전파, 손실, 계산 그래프
- 연쇄법칙(chain rule)과 역전파
- 기울기 계산과 매개변수 갱신의 차이
이름과 위치를 알아둘 개념
- 시그모이드(sigmoid), 하이퍼볼릭 탄젠트(tanh), ReLU
- 평균제곱오차, 이진·다중 클래스 교차엔트로피
- 자동미분
- 배치, 미니배치, 에포크
미분식을 손으로 길게 전개하는 것이 목표는 아니다. 계산을 작은 연산으로 나누면 연쇄법칙으로 각 매개변수의 영향도를 효율적으로 구할 수 있다는 흐름을 이해하는 것이 목표다.
이해에 필요한 항목
- 벡터 내적과 행렬 곱셈이 입력을 섞어 새 값을 만든다는 의미
- 합성함수와 연쇄법칙
- 기울기가 여러 변수에 대한 변화 방향을 모은 벡터라는 의미
- 확률과 로그의 기본 역할
가장 단순한 출발점: 선형 모형
입력 \(x\)가 여러 특성을 가진 벡터일 때 선형 모형은 다음처럼 예측한다.
\(w\)는 특성마다 중요도를 조절하는 가중치, \(b\)는 입력과 무관한 기준점을 조절하는 편향이다. 회귀에서는 \(z\) 자체를 연속값 예측으로 사용할 수 있다. 이진 분류에서는 시그모이드 함수를 통과시켜 0과 1 사이 값을 만든다.
이것이 로지스틱 회귀의 기본 형태다. 선형 결합과 확률적 출력 사이의 연결을 보여주므로, MLP와 분류 손실을 이해하는 좋은 출발점이다.
한 층으로 부족한 이유
퍼셉트론도 입력의 가중합을 계산한 뒤 임곗값을 넘는지에 따라 범주를 정한다. 그러나 하나의 선형 경계로만 나눌 수 있는 문제에 제한된다. XOR은 두 입력이 서로 다를 때만 1이 되는 간단한 규칙이지만, 입력 공간에서 하나의 직선으로 두 범주를 분리할 수 없다.
여러 선형 층만 연속으로 놓아도 이 한계를 해결하지 못한다. 선형변환의 합성은 다시 하나의 선형변환으로 정리되기 때문이다. 각 층 사이에 비선형 활성화를 넣어야 굽은 경계와 복합적인 관계를 표현할 수 있다.
다층 퍼셉트론은 변환을 층으로 합성한다
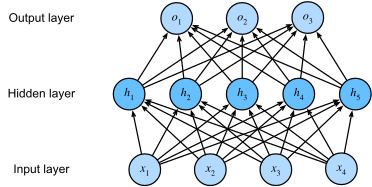
한 개의 은닉 층을 가진 MLP를 단순화하면 다음과 같다.
\(\phi\)는 은닉 표현에 비선형 변환을 주는 활성화 함수이고, \(g\)는 과제에 맞는 출력 변환이다. ReLU는 양수는 유지하고 음수는 0으로 만드는 단순한 함수다. 시그모이드와 하이퍼볼릭 탄젠트도 역사적으로 중요한 활성화 함수이지만, 깊은 모델에서는 기울기 흐름과 출력 범위 때문에 서로 다른 장단점이 있다.
MLP가 데이터의 규칙을 자동으로 안다는 뜻은 아니다. 층을 쌓아 더 다양한 함수를 표현할 수 있는 매개변수화를 제공할 뿐이다. 어떤 함수를 실제로 얻게 되는지는 데이터, 손실, 초기화, 옵티마이저와 학습 과정에 달려 있다.

순전파: 입력에서 예측까지
순전파는 입력을 첫 층부터 마지막 층까지 순서대로 계산하는 과정이다.
- 입력과 가중치를 곱하고 편향을 더한다.
- 활성화 함수로 비선형 표현을 만든다.
- 다음 층이 이 표현을 입력으로 받는다.
- 마지막 층이 과제에 맞는 예측을 출력한다.
- 예측과 목표값으로 손실을 계산한다.
학습 중에도, 학습이 끝난 뒤 추론할 때도 순전파는 사용된다. 차이는 학습 중에는 뒤이어 기울기를 계산하고 매개변수를 갱신하지만 추론에서는 보통 예측만 만든다는 점이다.
핵심 흐름 펼쳐보기: 손실에서 매개변수 갱신까지
손실 함수는 틀린 정도를 숫자로 만든다
회귀에서는 평균제곱오차(MSE)를 자주 사용한다.
이진 분류에서는 목표값 \(y\in\{0,1\}\)와 예측 확률 \(p\) 사이의 이진 교차엔트로피를 사용할 수 있다.
여러 범주 중 하나를 고르는 문제에서는 소프트맥스로 범주별 확률을 만들고 다중 클래스 교차엔트로피를 사용한다. 이 손실들은 단순한 관습이 아니라 출력의 의미와 데이터에 대한 확률적 가정에 연결된다. 다만 이 장에서는 그 유도보다 "출력 형식과 손실이 함께 설계되어야 한다"는 점을 기억하면 된다.
계산 그래프로 연산 순서를 본다
신경망의 복잡한 식도 덧셈, 곱셈, 활성화 같은 작은 연산의 연결로 나타낼 수 있다. 이를 계산 그래프라고 한다. 예를 들어
에서 손실 \(L\)은 \(a\)에, \(a\)는 \(z\)에, \(z\)는 \(w\)에 의존한다. 가중치가 손실에 미치는 영향은 연쇄법칙으로 연결된다.
각 항은 해당 국소 연산의 미분이다. 깊은 신경망도 원리는 같다. 출력 쪽에서 시작한 기울기를 그래프의 연결을 거슬러 전달하면서 이미 계산한 중간 결과를 재사용한다.
역전파가 하는 일
역전파는 스칼라 손실이 각 매개변수에 얼마나 민감한지를 효율적으로 계산한다. 결과는 \(\nabla_\theta L\)이며, 각 성분의 부호와 크기는 매개변수를 조금 바꿨을 때 손실이 어느 방향으로 얼마나 변할지 나타낸다.
중요한 구분은 다음과 같다.
- 역전파는 기울기를 계산하는 알고리즘이다.
- 경사하강법과 옵티마이저는 기울기를 이용해 매개변수를 갱신하는 규칙이다.
- 학습 방식은 학습 신호를 어디서 얻는지에 관한 구분이다.
따라서 지도 학습과 역전파는 동의어가 아니다. 자기지도 학습이나 강화 학습에서도 신경망 매개변수의 기울기는 흔히 역전파로 계산한다. 반대로 트리 기반 모델처럼 신경망이 아닌 모델은 다른 학습 알고리즘을 사용할 수 있다.
기울기가 매개변수 갱신으로 이어지는 지점
가장 기본적인 경사하강법 갱신은 다음과 같다.
\(\eta\)는 학습률이다. 기울기가 손실이 증가하는 방향을 가리키므로 반대 방향으로 이동한다. 이 한 줄이 실제 학습에서 안정적으로 작동하려면 미니배치 구성, 학습률, 옵티마이저, 초기화 같은 많은 선택이 필요하다. 이 문제는 3장에서 다룬다.
자동미분
PyTorch, JAX, TensorFlow 같은 프레임워크는 순전파에서 만들어진 연산 그래프와 각 연산의 미분 규칙을 이용해 기울기를 계산한다. 이를 자동미분(autodiff)이라고 한다. 자동미분은 수치 미분처럼 작은 간격으로 함숫값을 여러 번 비교하는 방식이 아니다. 또한 컴퓨터 대수 시스템이 식 자체를 변형해 닫힌 형태의 도함수 식을 만드는 기호 미분과도 다르다. 기호 미분은 사람이 직접 전개하는 것만을 뜻하지 않으며, 복잡한 식에서는 중간 표현이 매우 커지는 식 팽창이 생길 수 있다. 자동미분은 전체 도함수 식을 먼저 만들기보다 연산 단위의 미분 규칙을 연쇄법칙으로 조합해 주어진 입력에서 기울기 값을 계산한다.
자동미분이 미분의 의미를 대신해 주는 것은 아니다. 텐서가 그래프에서 끊겼거나, 미분 불가능한 연산을 넣었거나, 잘못된 손실을 사용해도 코드는 실행될 수 있다. 어떤 매개변수가 어떤 경로로 손실에 영향을 주는지 이해해야 문제를 진단할 수 있다.
배치, 미니배치, 에포크
- 배치는 한 번의 손실 계산에 함께 사용하는 샘플 집합을 뜻한다.
- 미니배치는 전체 데이터셋보다 작은 일부 샘플로 기울기를 추정한다.
- 반복(iteration) 또는 단계는 보통 한 미니배치에 대해 갱신 한 번을 수행한 단위다.
- 에포크는 훈련 데이터 전체를 한 차례 사용할 기회를 가진 단위다.
미니배치 기울기는 전체 데이터의 정확한 기울기가 아니라 추정치다. 계산과 메모리 부담을 줄이고, 추정의 변동성이 학습 경로에 영향을 준다. 배치 크기가 크면 무조건 더 좋거나 나쁘다고 단정할 수 없으며 학습률과 하드웨어, 정규화 방식과 함께 해석해야 한다.
자주 하는 혼동과 한계
자주 생기는 혼동과 한계
- 역전파가 가중치를 직접 바꾼다고 생각한다: 역전파는 기울기를 계산하고 옵티마이저가 갱신한다.
- 깊을수록 항상 더 좋은 함수를 학습한다고 생각한다: 표현 가능성은 커지지만 최적화, 데이터, 일반화 문제가 함께 커질 수 있다.
- 활성화를 출력의 후처리로만 본다: 은닉 층의 비선형 활성화가 없으면 여러 선형 층을 쌓아도 하나의 선형 모형과 같은 표현력에 머문다.
- 손실이 0에 가까우면 실제 목적을 달성했다고 본다: 훈련 손실과 검증 평가 지표, 데이터 분할을 함께 봐야 한다.
- 기울기의 절댓값이 매개변수 중요도라고 단정한다: 기울기는 현재 입력과 매개변수 위치에서의 국소 민감도이며 크기와 매개변수화의 영향을 받는다.
- 자동미분이 모델 설계를 검증한다고 생각한다: 자동미분은 주어진 계산을 미분할 뿐, 그 계산이 올바른 과제와 손실인지 판단하지 않는다.
앞뒤 장과의 연결
1장에서 정의한 모형, 매개변수, 손실이 이 장에서 하나의 계산 그래프로 연결되었다. 3장에서는 기울기 갱신, 깊이에 따른 신호 안정성, 일반화를 구분한다. 5장의 CNN, 7장의 트랜스포머, 8장의 GNN은 층의 연산 방식은 다르지만 순전파, 손실, 역전파라는 학습 골격을 공유한다.
스스로 확인하기
- 여러 선형 층 사이에 비선형 활성화가 없으면 하나의 선형 층과 무엇이 같아질까?
- 역전파, 옵티마이저, 지도 학습은 각각 어떤 질문에 답하는 개념일까?
- 순전파는 훈련과 추론에서 어떻게 공통으로 쓰이고, 그 뒤 과정은 어떻게 달라질까?
더 읽을 자료
- Rumelhart, Hinton, Williams, Learning representations by back-propagating errors, 1986. 역전파를 신경망 학습에 정착시킨 고전 논문: https://www.nature.com/articles/323533a0
- Goodfellow, Bengio, Courville, Deep Learning, 2016, 6장. 피드포워드 신경망을 다룬 공개 교재: https://www.deeplearningbook.org/contents/mlp.html
- PyTorch, Autograd mechanics, 2026-09-04 확인. 역방향 자동미분의 공식 설명: https://pytorch.org/docs/stable/notes/autograd.html
- JAX, Automatic differentiation, 2026-09-04 확인. 자동미분의 기본 연산과 변환을 설명하는 공식 문서: https://docs.jax.dev/en/latest/automatic-differentiation.html