12. 강화 학습
이 장의 질문
바로 얻는 보상과 먼 미래의 보상을 함께 고려해 행동을 선택하려면 어떻게 해야 할까?
강화 학습(Reinforcement Learning, RL)은 정답 레이블이 있는 샘플을 맞히는 문제와 다르다. 에이전트가 환경과 상호작용하면서 현재 행동뿐 아니라 뒤따를 보상까지 고려해 행동 전략을 배운다. 이 장에서는 다음 관계를 정리한다.
- MDP가 상호작용 문제를 어떻게 표현하는가
- 가치와 정책이라는 두 접근이 어떻게 나뉘는가
- Q-학습, DQN, 정책 기울기, 액터-크리틱, PPO가 지도에서 어디에 놓이는가
- 심층 강화 학습에서도 역전파가 어떤 역할을 하는가
읽기 수준과 선수지식 확인
읽기 전에 확인할 내용
- 조건부확률과 기댓값: 다음 상태와 기대 수익을 표현하는 데 쓰인다.
- 신경망과 함수 근사: 큰 상태 공간에서 가치나 정책을 근사한다.
- 역전파와 최적화: 2장과 3장에서 본 매개변수 갱신이 심층 강화 학습에도 쓰인다.
- 순차적 의사결정: 현재 행동이 미래의 관측과 보상에 영향을 준다.
1. 학습 문제를 이루는 요소
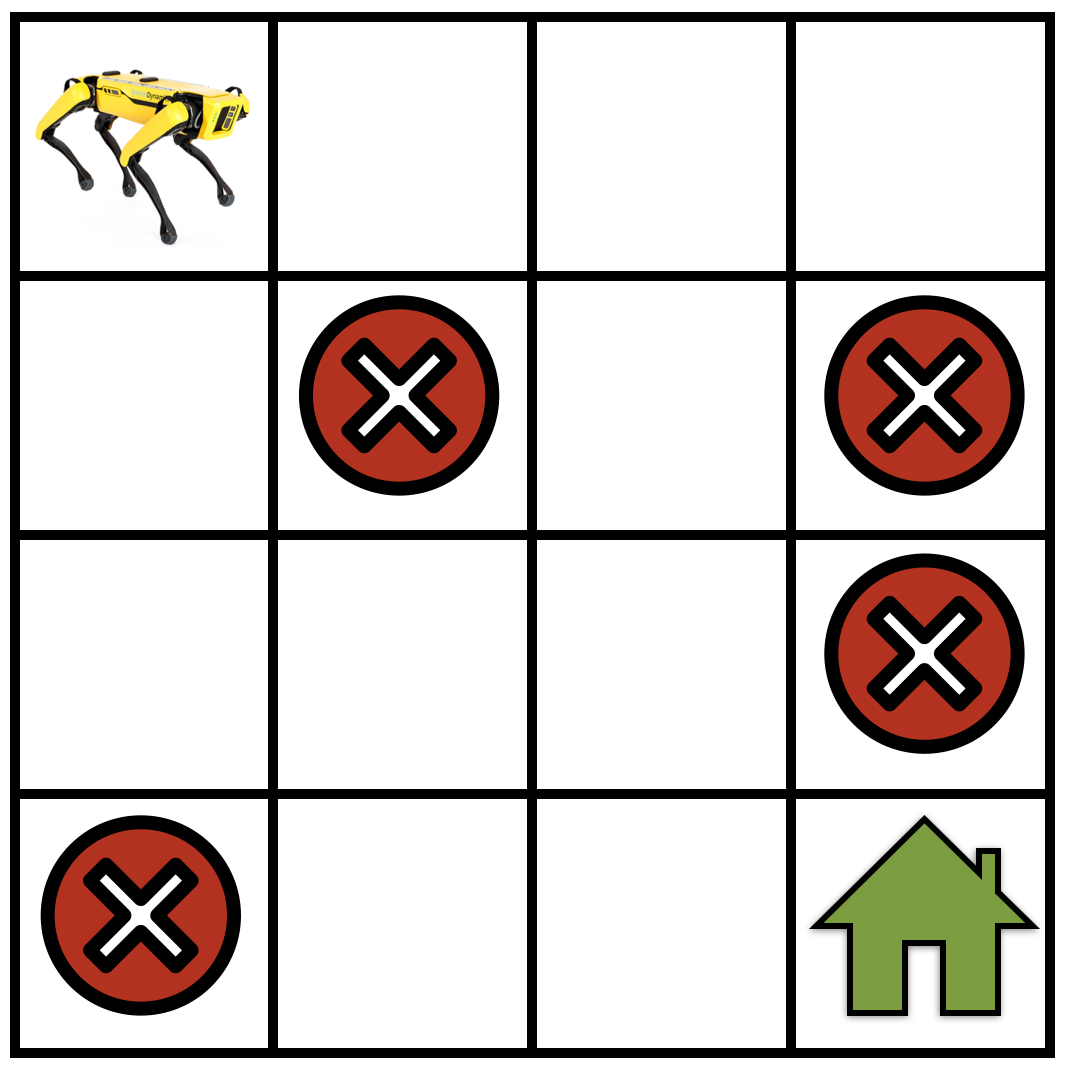
에이전트는 시간 \(t\)에 상태 \(s_t\)를 관측하고 행동 \(a_t\)를 선택한다. 환경은 보상 \(r_{t+1}\)과 다음 상태 \(s_{t+1}\)을 돌려준다. 이렇게 이어지는 상태와 행동의 흐름을 궤적(trajectory)이라고 한다.
마르코프 결정 과정(Markov decision process, MDP)는 보통 다음 요소로 표현한다.
- 상태 집합 \(\mathcal{S}\)
- 행동 집합 \(\mathcal{A}\)
- 전이 동역학 \(P(s'\mid s,a)\)
- 보상 함수
- 미래 보상의 비중을 조절하는 할인율 \(\gamma\)
마르코프 성질은 현재 상태가 미래를 예측하는 데 필요한 정보를 충분히 담는다는 가정이다. 실제 문제에서 관측값이 완전한 상태가 아닐 수 있다. 이 경우 부분 관측 가능한 MDP라는 더 넓은 설정이 필요하지만, 이 장에서는 이름과 문제의 존재만 알아둔다.

에이전트가 최대화하려는 대상은 즉시 보상 하나가 아니라 누적된 수익이다. 한 가지 정의는 다음과 같다.
정책 \(\pi(a\mid s)\)는 상태에서 어떤 행동을 선택할지 정한다. RL의 핵심은 장기적인 기대 수익을 높이는 정책을 찾는 것이다.
2. 가치 함수로 행동의 장기 효과를 요약하기
상태 값 \(V^\pi(s)\)는 정책 \(\pi\)를 따를 때 상태 \(s\)에서 기대할 수 있는 수익이다. 행동 값 \(Q^\pi(s,a)\)는 상태 \(s\)에서 행동 \(a\)를 선택한 뒤 정책을 따를 때의 기대 수익이다.
벨만 방정식은 현재 값을 즉시 보상과 다음 상태의 값으로 연결한다. 행동 값에 대한 관계는 다음 직관으로 읽으면 된다.
여기서 다음 행동은 \(a_{t+1}\sim\pi(\cdot\mid s_{t+1})\)로 정책 \(\pi\)를 따라 선택되며, 기댓값은 전이와 다음 행동의 불확실성을 함께 평균한다. 이 식은 값을 한 번에 최종 수익으로 맞히지 않고 한 단계 뒤의 추정값을 이용해 갱신할 수 있다는 아이디어로 이어진다. 이를 시간차(temporal-difference, TD) 학습이라고 한다.
3. Q-학습의 위치
Q-학습은 최적 행동 가치 \(Q^*(s,a)\)를 학습하는 대표적인 모델 프리, 가치 기반, 오프폴리시 알고리즘이다. 표 형태로 값을 저장하는 표 형식 설정에서 갱신은 다음과 같다.
대괄호 안은 TD 오차다. 현재 추정과 보상 + 다음 상태에서 가능한 최대 가치 사이의 차이를 줄인다.
- 모델 프리: 전이 모형을 명시적으로 학습하거나 알고 있다고 가정하지 않는다.
- 가치 기반: 정책을 직접 매개변수화하기보다 Q 값으로 행동을 고른다.
- 오프폴리시: 데이터를 모은 거동 정책과 학습 대상인 목표 정책이 달라도 된다.
SARSA는 다음에 현재 정책을 따라 실제로 선택한 \(a_{t+1}\)의 Q 값을 갱신 목표값에 사용한다. 따라서 대표적인 온폴리시 TD 제어 방법이다. Q-학습과 SARSA의 차이는 이름 암기보다 어떤 다음 행동의 가치를 목표값으로 쓰는가에 있다.
Q-학습은 RL 전체가 아니다. RL에는 정책을 직접 학습하는 방법, 환경 모형을 사용하는 방법, 오프라인 데이터로 학습하는 방법 등 여러 분기가 있다.
핵심 흐름 펼쳐보기: 탐험, DQN, 정책 계열 알고리즘
4. 탐험과 활용
현재 가장 좋아 보이는 행동만 반복하면 아직 시도하지 않은 더 좋은 행동을 놓칠 수 있다. 반대로 무작위 행동을 계속하면 보상을 충분히 얻지 못한다.
- 활용은 현재 지식을 이용해 좋은 행동을 고른다.
- 탐색은 불확실한 행동을 시도해 정보를 얻는다.
엡실론-그리디(\(\epsilon\)-greedy)는 일정 확률로 무작위 행동을 선택하고 나머지 경우에 가장 큰 Q 값을 가진 행동을 고르는 단순한 방법이다. 실제 탐색에는 엔트로피 보너스, 낙관적 탐색, 불확실성 기반 방법 등 더 많은 선택지가 있다. 어떤 방식도 모든 환경에서 탐색 문제를 자동으로 해결하지 않는다.
5. DQN은 무엇을 바꾸었는가
상태가 이미지처럼 크면 모든 상태-행동 쌍을 표에 저장할 수 없다. 심층 Q-망, DQN은 신경망 \(Q_\theta(s,a)\)로 행동 값을 근사한다. 신경망은 TD 목표값과 현재 예측의 차이를 줄이도록 역전파로 학습된다.
연속된 상호작용 데이터는 서로 강하게 상관되고, 갱신 중인 신경망이 자기 자신의 목표값도 바꾸기 때문에 학습이 불안정해질 수 있다. DQN은 두 장치를 사용해 이를 완화했다.
- 경험 재현: 과거 전이를 버퍼에 저장하고 섞어서 미니배치로 샘플링한다.
- 목표 신경망: TD 목표값 계산에 쓰는 매개변수를 일정 기간 고정하거나 천천히 갱신한다.
DQN의 경험 재현은 과거 거동 정책이 모은 데이터로도 학습할 수 있는 오프폴리시 Q-학습과 자연스럽게 연결된다. 반면 현재 정책이 만든 궤적 분포를 전제로 하는 온폴리시 정책 기울기에는 과거 전이를 그대로 섞어 순진하게 재사용할 수 없다. 정책 차이를 보정하거나 그에 맞게 설계된 별도 알고리즘이 필요하다.
DQN은 Q-학습과 신경망의 결합이라고 요약할 수 있지만 단순히 신경망을 붙인 것만으로 안정적인 학습이 보장되지는 않는다. 재현 데이터 분포, 보상 크기, 탐색, 목표 신경망 갱신 등 여러 선택이 결과에 영향을 준다. 또한 기본 DQN은 이산 행동을 전제로 한다.
6. 정책을 직접 학습하기
정책 기반 방법은 매개변수화된 정책 \(\pi_\theta(a\mid s)\)를 직접 최적화한다. 행동이 연속적이거나 확률적 정책이 필요한 문제에서 자연스러운 선택이 될 수 있다.
정책 기울기의 핵심 형태는 다음과 같이 읽을 수 있다.
기댓값은 정책이 만든 궤적에 대해 계산되며, 기울기에는 한 시점만이 아니라 궤적의 여러 시점에서 나온 항이 함께 기여한다. 수익이 큰 행동의 로그 확률을 높이는 방향으로 매개변수를 바꾼다는 뜻이다. REINFORCE는 이 아이디어를 몬테카를로 수익으로 구현한 대표적인 알고리즘이며, 일반적인 형태는 온폴리시다. 개념은 단순하지만 기울기 추정치의 분산이 클 수 있다.
여기서도 실제 매개변수 갱신에는 역전파와 옵티마이저가 쓰인다. 정책 기울기는 역전파의 대안이 아니라, 정책 매개변수에 대해 어떤 목적 함수의 기울기를 계산할지 정하는 방법이다.
7. 액터-크리틱과 어드밴티지
액터-크리틱은 두 역할을 결합한다.
- 액터는 정책을 나타내고 행동을 선택한다.
- 크리틱은 상태나 행동의 값을 추정해 액터의 갱신을 돕는다.
크리틱을 이용하면 전체 수익만 기다리지 않고 더 낮은 분산의 학습 신호를 만들 수 있다. 어드밴티지 \(A(s,a)\)는 특정 행동이 그 상태에서 평균적인 선택보다 얼마나 나은지 나타낸다.
액터는 양의 어드밴티지를 가진 행동의 확률을 높이고 음의 어드밴티지를 가진 행동의 확률을 낮추는 방향으로 학습할 수 있다. 하지만 크리틱의 값 추정치에 편향이나 오차가 있으면 액터도 잘못된 방향으로 갱신될 수 있다.
액터-크리틱은 액터와 크리틱을 함께 쓴다는 구조를 가리키며, 그것만으로 온폴리시 여부가 정해지지는 않는다. 데이터를 모으고 갱신에 사용하는 방식에 따라 온폴리시 액터-크리틱도 있고 오프폴리시 액터-크리틱도 있다.
8. PPO의 위치
근접 정책 최적화(Proximal Policy Optimization, PPO)는 정책 기울기와 액터-크리틱 계열에서 널리 알려진 알고리즘이며, 일반적인 형태는 온폴리시다. 갱신 직전 정책으로 롤아웃을 모은 뒤 그 데이터로 여러 번 갱신할 때 확률비가 지나치게 변하지 않도록 클리핑된 목적 함수를 사용하고, 갱신이 끝나면 새 정책으로 다시 데이터를 모은다.
핵심 직관은 한 번의 갱신에서 정책을 너무 크게 바꾸지 않도록 제한한다는 것이다. 이것이 모든 환경에서 안정성이나 최적 성능을 보장한다는 뜻은 아니다. PPO 결과는 보상 설계, 롤아웃 길이, 어드밴티지 추정, 정규화, 하이퍼파라미터에 민감할 수 있다.
PPO의 위치는 다음 네 문장으로 정리할 수 있다.
정책 기울기 -> 액터-크리틱 -> 이점을 사용한 갱신 -> PPO의 클리핑된 갱신
세부 대리 목적 함수 유도와 일반화 어드밴티지 추정은 후속 심화 주제다.
9. 강화 학습 알고리즘 지도를 한 번에 보기
- 표 형식 가치 학습: TD 학습, SARSA, Q-학습
- 심층 값 학습: DQN과 그 변형
- 직접 정책 최적화: REINFORCE와 정책 기울기
- 값과 정책의 결합: 액터-크리틱
- 제한된 정책 갱신의 한 예: PPO
- 별도의 축: 모델 기반 RL, 오프라인 강화 학습, 모방 학습, 다중 에이전트 강화 학습
이 분류는 상호 배타적인 완전한 분류표가 아니다. 현대 알고리즘은 여러 아이디어를 결합한다. 논문을 읽을 때는 이름보다 정책, 값, 모형, 데이터 수집 방식, 온폴리시 또는 오프폴리시 여부를 확인한다.
이 장에서 기억할 내용
- RL은 행동이 미래 상태와 보상을 바꾸는 순차적 의사결정 문제다.
- 가치 기반 방법은 행동의 장기 가치를 추정하고, 정책 기반 방법은 행동 분포를 직접 학습한다.
- Q-학습은 RL의 한 유형이고, DQN은 Q 값을 신경망으로 근사한다.
- 액터-크리틱은 정책과 가치 추정기를 함께 사용하며 PPO는 이 분기의 대표적인 정책 최적화 방법이다.
- 심층 RL의 신경망 매개변수는 보통 역전파로 학습된다.
이름과 위치만 알아둘 내용
- 부분 관측 가능한 MDP
- 모델 기반 RL
- 오프라인 강화 학습과 분포 변화
- 일반화 어드밴티지 추정
- 엔트로피 규제
- 연속 제어 알고리즘
- 보상 모형과 선호 기반 강화 학습
자주 하는 혼동과 한계
자주 생기는 혼동과 한계
보상이 레이블을 대신하는가
부분적으로 학습 신호라는 역할은 비슷하지만 구조가 다르다. 보상은 지연되고 희소할 수 있으며 에이전트의 행동에 따라 모이는 데이터 자체가 달라진다.
높은 훈련 보상이면 문제가 해결되었는가
아니다. 에이전트가 의도하지 않은 지름길을 찾는 보상 편법이 생길 수 있다. 여러 난수 초깃값, 별도로 남겨 둔 조건, 안전성 제약, 실제 목표와의 정합성을 평가해야 한다.
환경 상호작용은 독립 동일분포 데이터인가
아니다. 연속된 샘플은 상관되어 있고 정책이 변하면 데이터 분포도 변한다. 지도 학습의 고정 데이터셋과 다른 어려움이다.
PPO는 항상 안전하고 안정적인가
아니다. 클리핑은 갱신을 제어하는 경험적 규칙 장치이며 안정성과 성능을 보장하는 증명은 아니다.
RL은 생성 모델의 다음 단계인가
아니다. RL은 보상 기반 의사결정이라는 별도 분기다. 생성 모델과 결합할 수 있지만 선수관계는 아니다.
앞뒤 장과의 연결
- 1장: 출력은 정답 예측이 아니라 행동이고 학습 신호는 순차적 보상이다.
- 2장과 3장: DQN, 정책 신경망, 크리틱 신경망도 역전파와 옵티마이저를 사용한다.
- 7장: 트랜스포머가 정책이나 값 기반망으로 사용될 수 있지만 RL과 트랜스포머는 같은 개념이 아니다.
- 13장: 과학에서는 실험 조건 선택, 제어, 역설계와 연결될 수 있다. 단, 14장과 15장의 필수 선수는 아니다.
스스로 확인하기
- Q-학습이 RL 전체가 아니라 가치 기반 분기의 한 방법이라고 말하는 이유는 무엇인가?
- DQN과 표 형식 Q-학습은 Q 값을 어떻게 표현하며, DQN의 두 안정화 장치는 무엇을 완화하려는가?
- 정책 기울기와 액터-크리틱은 가치 기반 행동 선택과 어떤 점에서 다른가?
- 높은 훈련 보상과 실제 목표 달성을 구분하려면 무엇을 검증해야 하는가?
더 읽을 자료
- Sutton and Barto, Reinforcement Learning: An Introduction, 제2판, 저자 공개본: http://incompleteideas.net/book/the-book-2nd.html
- Watkins and Dayan, Q-learning, Machine Learning 1992: https://doi.org/10.1007/BF00992698
- Mnih et al., Human-level control through deep reinforcement learning, Nature 2015: https://doi.org/10.1038/nature14236
- Sutton et al., Policy Gradient Methods for Reinforcement Learning with Function Approximation, NeurIPS 1999: https://papers.nips.cc/paper/1713-policy-gradient-methods-for-reinforcement-learning-with-function-approximation
- Schulman et al., Proximal Policy Optimization Algorithms: https://arxiv.org/abs/1707.06347
처음에는 Sutton과 Barto의 에이전트-환경 도식과 Q-학습, DQN, PPO 논문의 초록과 알고리즘의 위치를 확인한다. 증명과 구현 세부는 후속 학습으로 남겨도 된다.