7. 어텐션과 트랜스포머
이 장의 질문
출력을 만들 때 입력의 어느 부분을 참고할지 모형이 어떻게 정할까?
6장의 시퀀스-투-시퀀스 모형은 입력 수열 전체를 하나의 고정 길이 문맥 벡터로 압축했다. 어텐션은 출력할 내용에 맞춰 입력의 어느 부분을 참고할지 그때그때 계산한다. 트랜스포머는 이 선택 과정을 수열 처리의 중심 연산으로 삼는다. 쿼리, 키, 값의 역할과 자기 어텐션만으로는 순서를 알 수 없는 이유, 인코더와 디코더에서 마스크를 다르게 쓰는 이유를 차례로 살펴본다.
읽기 수준과 선수지식 확인
읽기 전에 확인할 내용
- 6장의 토큰화, 임베딩, 시퀀스-투-시퀀스
- 벡터 내적과 가중합
- 행렬 곱셈과 배열의 크기
- 소프트맥스가 값을 합이 1인 가중치로 바꾸는 역할
- 3장의 잔차 연결과 정규화
1. 고정 문맥에서 필요한 위치 선택으로
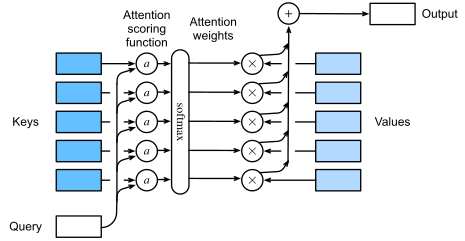
번역 디코더가 다음 단어를 만들 때 항상 입력 문장 전체를 똑같이 참고할 필요는 없다. 특정 출력 단어는 특정 입력 단어와 더 직접적으로 대응한다. 인코더-디코더 어텐션은 디코더의 현재 상태와 각 인코더 위치를 비교해 관련성 점수를 만들고, 점수가 큰 위치의 정보를 더 많이 모은다.
이를 세 역할로 나누면 다음과 같다.
- 쿼리는 지금 찾고 있는 정보의 표현이다.
- 키는 각 후보가 어떤 정보인지 비교하기 위한 표지다.
- 값은 그 후보가 선택되었을 때 실제로 가져올 내용이다.
검색에 비유하면 쿼리로 모든 키를 조회해 관련도를 구한 뒤, 관련도에 따라 값을 섞는다. 이 비유는 역할을 이해하는 데 유용하지만, 실제 모델에서는 세 값 모두 입력 벡터에 학습된 선형변환을 적용해 만든다.
2. 크기 조정 내적 어텐션
행렬 \(Q\), \(K\), \(V\)가 있을 때 트랜스포머의 기본 어텐션은 다음처럼 쓸 수 있다.
계산은 네 단계로 읽을 수 있다.
- 각 쿼리와 모든 키의 내적으로 관련성 스코어를 만든다.
- \(\sqrt{d_k}\)로 나누어 내적값의 크기가 차원과 함께 지나치게 커지는 것을 완화한다.
- 소프트맥스로 각 쿼리에 대한 가중치를 만든다.
- 가중치에 따라 값을 합쳐 새로운 표현을 만든다.
어텐션 가중치는 모델이 어떤 위치를 많이 사용했는지 보여주지만, 그 자체를 완전한 인과 설명으로 해석해서는 안 된다. 여러 층과 헤드, 잔차 경로가 함께 출력에 영향을 주며, 가중치가 높다는 사실만으로 그 토큰이 인간 관점의 이유였다고 결론낼 수 없다.

3. 셀프 어텐션은 시퀀스 내부의 관계를 만든다
자기 어텐션에서는 쿼리, 키, 값이 같은 입력 수열에서 나온다. 각 토큰은 다른 모든 토큰을 참고해 자신의 표현을 갱신한다. 따라서 멀리 떨어진 두 토큰도 한 층 안에서 직접 정보를 주고받을 수 있다.
RNN과 비교하면 차이가 선명하다.
- RNN은 이전 은닉 상태를 거쳐 정보를 순차적으로 전달한다.
- 자기 어텐션은 한 층 안에서 모든 위치 쌍의 관계를 계산할 수 있어 학습 시 병렬화하기 쉽다.
- 기본 자기 어텐션의 연산과 메모리는 수열 길이에 대해 대체로 제곱으로 증가하므로 긴 수열에서 비용이 커질 수 있다.
자기 어텐션이 항상 RNN보다 우월하다는 뜻은 아니다. 데이터 크기, 시퀀스 길이, 지연 시간, 스트리밍 조건, 모형 구조에 따라 적합한 선택이 달라진다.
핵심 흐름 펼쳐보기: 멀티헤드, 위치 정보, 인코더와 디코더
4. 멀티헤드 어텐션이 여러 관계를 나누어 본다
다중 헤드 어텐션은 하나의 큰 어텐션을 한 번 계산하는 대신 여러 헤드에서 서로 다른 투영을 사용한다. 각 헤드는 다른 표현 부분공간에서 관계를 계산하고, 결과를 이어 붙여 다시 변환한다.
이 구조는 위치 사이의 관계를 여러 관점으로 표현할 여지를 준다. 그러나 특정 헤드가 반드시 문법, 의미, 공지시 같은 사람이 이름 붙인 기능 하나만 담당한다는 보장은 없다. 헤드의 역할은 학습 결과이며 모델과 데이터에 따라 달라진다.
5. 순서 정보는 따로 넣어야 한다
자기 어텐션만 놓고 보면 입력 토큰의 순서를 동시에 바꾸었을 때 같은 방식으로 재배열된 출력을 만든다. 즉, 토큰 집합은 처리하지만 A가 B보다 앞에 있다는 위치 정보를 자체적으로 알지 못한다.
그래서 토큰 임베딩에 위치 정보를 추가한다.
- 고정된 사인·코사인 위치 인코딩
- 학습 가능한 위치 임베딩
- 상대적 거리나 회전에 기반한 상대 또는 회전 위치 표현
세부 방식은 다르지만 목적은 같다. 모델이 내용과 위치를 함께 사용하도록 만드는 것이다. 최대 문맥 길이와 외삽 특성은 위치 표현 방식과 학습 설정에 영향을 받는다.
6. 트랜스포머 블록의 구성
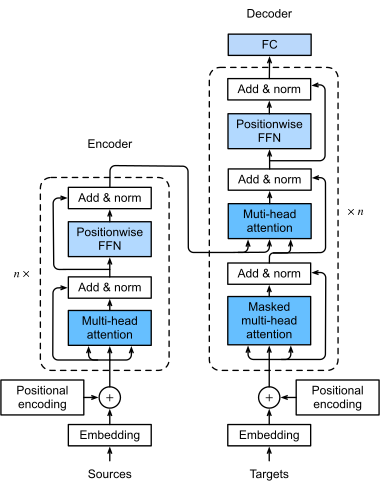
트랜스포머 블록은 보통 다음 요소를 반복한다.
- 다중 헤드 자기 어텐션
- 위치별 피드포워드 신경망
- 잔차 연결
- 층 정규화
어텐션은 토큰 사이의 정보를 섞고, 피드포워드 신경망은 각 위치의 표현을 비선형적으로 변환한다. 잔차 연결과 정규화는 깊은 신경망의 정보 흐름과 최적화를 안정화하는 역할을 한다. 사전 정규화와 사후 정규화처럼 세부 배치는 모델마다 다를 수 있다.

7. 인코더와 디코더는 마스크가 다르다
트랜스포머 인코더는 일반적으로 입력 전체를 양방향으로 참고한다. 문서 분류나 토큰 레이블링처럼 전체 입력이 이미 주어진 문제에 적합하다.
트랜스포머 디코더는 자기회귀 생성에서 현재 위치가 미래 정답 토큰을 보지 못하도록 인과 마스크를 사용한다. 그렇지 않으면 학습 중 정답을 미리 보는 누출이 생긴다. 패딩 토큰을 무시하는 패딩 마스크와 미래 위치를 가리는 인과 마스크는 목적이 다르다.
원래 트랜스포머의 인코더-디코더 구조에서는 디코더가 세 종류의 계산을 한다.
- 이미 생성된 출력에 대한 가린 자기 어텐션
- 인코더 출력에 대한 교차 어텐션
- 위치별 피드포워드 신경망
현대 모델은 목적에 따라 인코더 전용, 디코더 전용, 인코더-디코더 형태를 선택한다.
8. 모델 구조와 학습 목표를 분리하기
BERT는 트랜스포머 인코더를 사용하고, 입력 일부를 가린 뒤 원래 토큰을 맞히는 가림 언어 모델링을 대표적으로 사용한다. GPT 계열은 트랜스포머 디코더를 사용하고, 앞의 토큰으로 다음 토큰을 예측한다.
여기서 중요한 구분은 다음과 같다.
- 트랜스포머는 정보를 계산하는 모형 구조다.
- 가린 토큰 예측과 다음 토큰 예측은 학습 목적 함수다.
- 사전 학습은 대규모 데이터에서 일반 표현이나 생성 능력을 먼저 학습하는 학습 단계다.
- 미세 조정과 프롬프팅은 사전 학습된 모형을 후속 과제에 사용하는 서로 다른 적응 방식이다.
같은 모형 구조도 목적 함수와 데이터가 달라지면 다른 능력과 실패 양상을 보일 수 있다. 반대로 같은 목적 함수를 반드시 하나의 모형 구조로만 풀어야 하는 것도 아니다.
9. 트랜스포머는 자연어 처리 전용 구조가 아니다
이미지 패치, 시계열 구간, 그래프 노드, 오디오 프레임처럼 데이터를 토큰 수열로 표현할 수 있다면 트랜스포머를 적용할 수 있다. 비전 트랜스포머는 이미지를 패치 토큰으로 보고, 다중양식 트랜스포머는 서로 다른 양식의 표현을 하나의 시퀀스나 교차 어텐션으로 연결한다.
그러나 모든 것을 토큰으로 만들 수 있다와 데이터 구조를 충분히 반영했다는 같은 말이 아니다. 이미지의 국소성, 그래프의 연결성, 3차원 회전 대칭처럼 중요한 귀납 편향을 토큰화와 위치 표현, 어텐션 패턴에 어떻게 넣을지 별도로 결정해야 한다.
이 장에서 기억할 내용
꼭 이해할 내용
- 쿼리, 키, 값과 가중합의 역할
- 인코더-디코더 어텐션과 자기 어텐션의 차이
- 위치 정보가 필요한 이유
- 인코더, 디코더, 교차 어텐션, 인과 마스크의 관계
- 모형 구조, 목적 함수, 훈련 단계의 구분
다음 공부를 위해 알아둘 내용
- 다중 헤드 어텐션과 피드포워드 블록의 세부 배열 모양
- 상대 위치, 회전 위치 표현
- BERT와 가린 토큰 목적 함수
- GPT와 다음 토큰 목적 함수
- 비전 트랜스포머, 시계열 트랜스포머, 다중양식 트랜스포머
- 기반 모형과 크기 조정
자주 하는 혼동과 한계
자주 생기는 혼동과 한계
어텐션은 설명 전체가 아니다
어텐션 가중치는 내부 정보 사용의 한 단면이다. 이를 바로 인간이 이해하는 중요도나 인과적 근거로 등치하면 안 된다.
트랜스포머와 LLM은 같은 범주가 아니다
트랜스포머는 모형 구조이고, LLM은 대규모 언어 데이터와 학습 목적 함수, 계산 규모를 결합한 언어 모델 범주다. 작은 트랜스포머도 있고, 언어 이외 데이터의 트랜스포머도 있다.
- 긴 시퀀스에서는 어텐션의 계산량과 메모리가 병목이 될 수 있다.
- 문맥 창 안에 정보가 있다는 사실만으로 모델이 그 정보를 정확히 사용한다는 보장은 없다.
- 사전 학습 말뭉치의 편향, 중복, 시간 범위가 출력에 반영된다.
- 생성 확률이 높다는 것과 사실이 참이라는 것은 다르다.
- 토크나이저와 문맥 길이가 전문 용어, 수식, 긴 문서 처리 품질을 제한할 수 있다.
다섯 질문으로 다시 보기
- 입력과 출력: 임베딩 수열을 받아 문맥형 표현이나 다음 토큰 분포를 출력한다.
- 구조적 가정: 위치 사이의 관계를 어텐션으로 계산하고, 순서는 위치 정보로 제공한다.
- 학습 신호: 가린 토큰, 다음 토큰, 번역 목표값, 과제 레이블 등 목적 함수에 따라 달라진다.
- 기준 모델: RNN, LSTM, TF-IDF 기반 모델이나 과제별 단순 모델과 비교한다.
- 평가: 과제 평가 지표뿐 아니라 입력 길이, 추론 비용, 보정, 도메인 변화와 사실성을 따로 확인한다.
- 실패 조건: 긴 문맥, 희귀한 표현, 학습 시점 이후 정보, 분포가 다른 전문 말뭉치에서 성능이 달라질 수 있다.
앞뒤 장과의 연결
6장의 토큰화와 임베딩이 트랜스포머의 입력을 만든다. RNN의 고정 문맥 병목이 어텐션의 동기가 된다. 8장에서는 순서 대신 임의의 연결 관계를 가진 그래프를 다루며, 어텐션의 가중 집계는 GAT와 그래프 트랜스포머에서 다시 나타난다. 10장에서는 트랜스포머가 언어 생성이 아니라 확산 잡음 제거기로도 사용될 수 있음을 본다.
스스로 확인하기
- 인코더-디코더 어텐션과 자기 어텐션은 쿼리, 키, 값의 출처가 어떻게 다른가?
- 자기 어텐션에 위치 정보가 필요한 이유는 무엇인가?
- 패딩 마스크와 인과 마스크는 각각 어떤 정보를 차단하는가?
- 트랜스포머 모형 구조와 다음 토큰 목적 함수를 왜 구분해야 하는가?
더 읽을 자료
- Bahdanau, Cho, and Bengio, Neural Machine Translation by Jointly Learning to Align and Translate, 2015. 신경망 어텐션의 대표 초기 논문
- Vaswani et al., Attention Is All You Need, 2017. 트랜스포머 원 논문
- Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, 2019. 인코더 중심 사전 학습의 대표 사례
- Radford et al., Improving Language Understanding by Generative Pre-Training, 2018. GPT 계열의 초기 공식 기술 보고서
- Dosovitskiy et al., An Image is Worth 16x16 Words, 2021. 트랜스포머를 이미지 패치에 적용한 대표 논문