14. PINN과 신경 연산자
이 장의 질문
미분방정식 문제에 신경망을 쓰는 PINN과 신경 연산자는 무엇이 다를까?
편미분방정식(partial differential equation, PDE)으로 정의된 문제에 신경망을 쓰는 방법은 여러 가지다. 자주 함께 언급되지만 학습 대상이 다른 물리 정보 신경망(physics-informed neural network, PINN)과 신경 연산자(neural operator)를 구분해 보자.
- 표준적인 PINN은 주어진 PDE 사례의 해 함수를 신경망으로 나타내고 방정식 잔차를 줄인다.
- 신경 연산자는 입력 함수에서 출력 함수로 가는 대응 관계를 여러 사례의 입력·출력 데이터로 학습한다.
두 방법의 입력과 출력, 학습 신호, 비용 구조, 검증 방법을 비교하는 데 초점을 맞춘다.
읽기 수준과 선수지식 확인
읽기 전에 확인할 내용
- PDE: 여러 독립변수에 대한 미분 관계로 현상을 표현한다.
- 초기조건(initial condition, IC): 시간에 따라 변하는 문제의 시작 상태를 정한다.
- 경계조건(boundary condition, BC): 영역의 경계에서 해가 만족해야 하는 조건을 정한다.
- 자동미분: 신경망 출력을 입력에 대해 미분한다.
- 함수와 연산자: 함수는 값을 다른 값으로 보내고, 연산자는 함수를 다른 함수로 보낸다.
- 푸리에 변환: 공간 신호를 주파수 성분으로 나타낸다. FNO를 이해하는 데 도움이 되는 선택 배경이다.
5장의 합성곱과 푸리에 관련 내용은 FNO를 이해할 때 도움이 되지만, PINN과 신경 연산자의 학습 대상 차이를 파악하는 데 필수는 아니다. PDE의 적절성(well-posedness), 수치 안정성, 약한 해는 별도의 수치해석 학습이 필요한 주제다.
1. 공통 예제로 문제를 고정하기
영역 \(\Omega\)에서 해 \(u(x)\)가 다음 관계를 만족한다고 하자.
\(\mathcal{N}\)은 미분 연산자이고, \(f\)는 원천항이나 강제항일 수 있다. 경계에서는 \(\mathcal{B}[u](x)=g(x)\) 같은 조건을 만족한다.
여기서 서로 다른 두 질문을 만들 수 있다.
- \(f\), 계수, 경계 조건이 고정된 이 한 문제의 해 \(u\)를 구하고 싶은가
- 서로 다른 \(f\), 계수, 초기 조건이 주어질 때마다 해를 내는 연산자 \(G:f\mapsto u\)를 학습하고 싶은가
첫 질문은 전형적인 PINN 문제 설정과, 두 번째 질문은 신경 연산자 문제 설정과 가깝다. 실제 연구에는 여러 변형과 혼합형이 있으므로 이것은 입문용 기준선이다.
2. PINN은 해를 신경망으로 표현한다
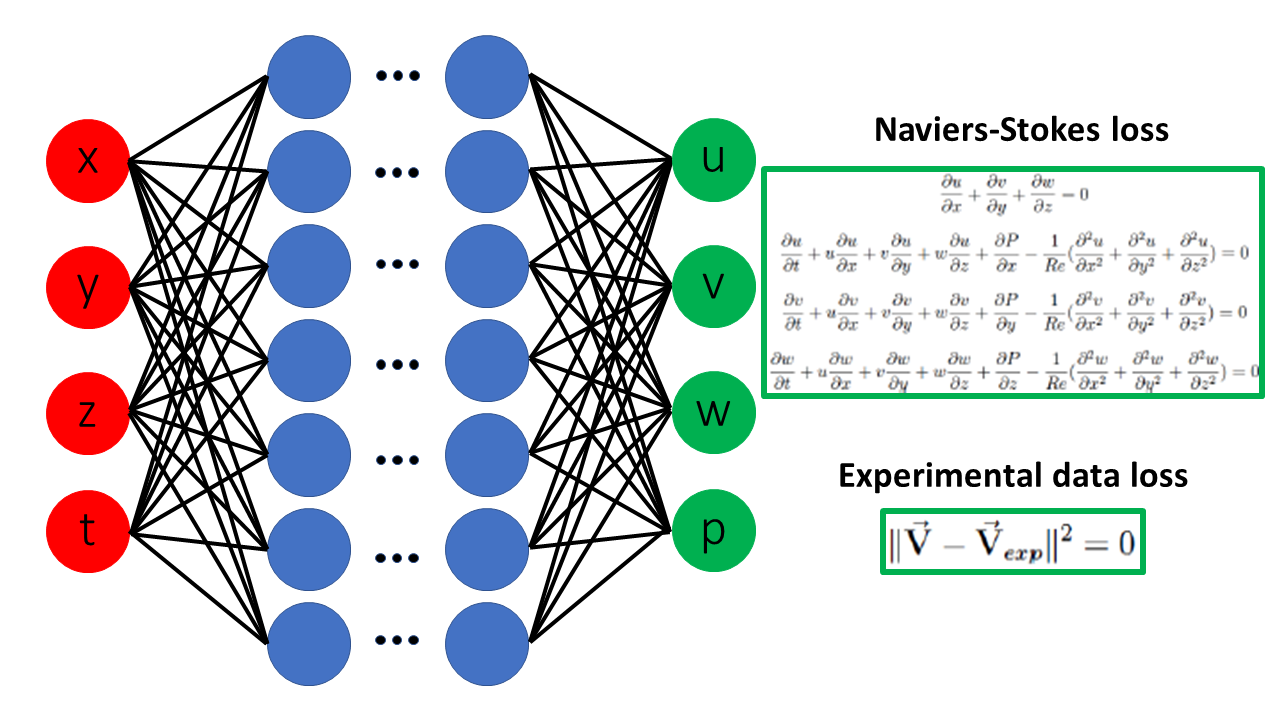
PINN은 좌표 \(x\) 또는 \((x,t)\)를 입력으로 받아 해 값을 출력하는 신경망 \(u_\theta(x,t)\)를 둔다. 자동미분으로 필요한 도함수를 계산한 뒤 PDE 잔차를 만든다.
대표적인 손실은 여러 항의 합이다.
- 잔차 손실은 영역 내부의 콜로케이션 점에서 PDE 위반을 측정한다.
- 경계 손실은 경계 조건 위반을 측정한다.
- 초기 손실은 시작 상태와의 차이를 측정한다.
- 데이터 손실은 관측 또는 시뮬레이션 값이 있을 때 예측과 데이터의 차이를 측정한다.
모든 문제에 네 항이 전부 필요한 것은 아니다. 어떤 항을 쓰고 어떻게 가중치를 정했는지가 문제 정의의 일부다.

3. 콜로케이션 점과 자동미분
콜로케이션 점은 PDE 잔차를 평가하는 좌표다. 배치점이라고도 부르며, 규칙 격자일 필요는 없다. 영역 내부나 중요한 구간에서 뽑을 수 있지만, 유한한 지점의 잔차가 작다는 사실만으로 전체 영역의 해 오차가 작다고 보장되지는 않는다.
자동미분은 유한차분 없이 신경망 계산 그래프를 따라 도함수를 계산할 수 있게 한다. 이것은 기호 미분이나 전통적 이산화와 같은 개념이 아니다.
- 신경망이 입력 좌표에 대해 미분 가능해야 한다.
- 고차 도함수는 계산과 최적화를 어렵게 만들 수 있다.
- 자동미분은 도함수를 계산할 뿐, PDE 해의 정확성을 보장하지 않는다.
핵심 흐름 펼쳐보기: 역문제와 신경 연산자
4. PINN 학습이 어려운 이유
PINN도 신경망 최적화 문제이므로 손실 지형과 기울기 문제가 있다. 특히 서로 다른 손실 항이 서로 경쟁하는 기울기나 매우 다른 크기를 가질 수 있다.
- PDE 잔차는 작아지지만 경계 조건이 잘 맞지 않을 수 있다.
- 급격한 변화나 다중 규모 해를 신경망이 표현하고 최적화하기 어려울 수 있다.
- 이류 지배, 혼돈, 강성 문제에서 학습 난도가 커질 수 있다.
- 콜로케이션 점 샘플링이 중요한 영역을 놓칠 수 있다.
- 같은 잔차 크기라도 관심 물리량의 해 오차는 다를 수 있다.
적응형 샘플링, 손실 가중, 영역 분할, 교육과정 훈련, 약형 정식화 등이 제안되는 이유다. 이 방법들은 만능 처방이 아니라 각각 추가 가정과 하이퍼파라미터를 가진다.
5. PINN은 역문제에도 쓰인다
미지의 PDE 계수를 매개변수 \(\phi\)로 두고 \(u_\theta\)와 함께 학습하면 관측 데이터와 방정식을 이용한 역문제를 구성할 수 있다. 이때 매개변수 식별 가능성을 확인해야 한다. 서로 다른 계수가 비슷한 관측을 만들면 손실을 줄였다는 사실만으로 참 매개변수를 복원했다고 말할 수 없다.
노이즈, 센서 위치, 경계 조건의 정확성, 매개변수 사전 분포가 결과에 영향을 준다. 합성 데이터에서의 복원과 실제 측정값에서의 복원은 별도로 검증해야 한다.
6. 신경 연산자는 문제군을 학습한다
신경 연산자는 함수 \(a\)를 받아 해 함수 \(u\)를 내는 연산자 \(G\)를 근사한다.
\(a\)는 계수 장, 초기 조건, 강제 함수 등이 될 수 있다. 훈련 데이터는 보통 여러 PDE 사례에서 얻은 쌍 \((a_i,u_i)\)로 구성된다. 짝지은 해를 만들기 위해 기존 수치 풀이법을 반복 실행해야 할 수 있다.
훈련 비용을 먼저 지불하고 여러 새 입력 함수의 해를 빠르게 예측한다는 관점이 중요하다. 한 번만 풀 문제라면 데이터 생성과 훈련에 드는 비용 때문에 이점이 없을 수 있다. 비슷한 계열의 문제를 반복해서 풀 때 비용 구조가 달라진다.
7. DeepONet의 브랜치와 트렁크 관점
DeepONet은 연산자를 두 성분으로 표현한다.
- 분기 신경망은 센서 지점에서 관측한 입력 함수 값을 인코딩한다.
- 몸통 신경망은 해를 평가할 출력 좌표를 인코딩한다.
두 표현을 결합해 해당 좌표에서의 해 값을 예측한다. 이 구성은 어떤 입력 함수인가와 어느 위치의 출력을 묻는가를 분리해 생각하게 한다.
센서 위치, 수, 훈련 분포가 바뀌면 성능이 달라질 수 있다. 연산자를 학습한다는 이름만으로 임의의 함수나 기하 구조에 일반화하는 것은 아니다.
8. 푸리에 신경 연산자의 주파수 관점
푸리에 신경 연산자, FNO는 장을 잠재 표현으로 올린 뒤 푸리에 영역에서 선택된 모드에 학습된 변환을 적용하고 다시 공간 영역으로 돌아오는 층을 사용한다. 공간 영역의 점별 변환과 함께 쌓아 연산자를 근사한다.
핵심 직관은 합성곱을 주파수 영역에서 효율적으로 표현하고 넓은 공간 상호작용을 다룬다는 것이다. FNO가 전통적 스펙트럼 수치 풀이법과 동일하다는 뜻은 아니다. 학습된 매개변수와 비선형 층을 가진 데이터 기반 연산자 모형이다.
원 논문은 한 해상도에서 학습하고 다른 이산화에서 평가하는 가능성을 보여주었지만, 해상도 일반화가 자동으로 보장되는 것은 아니다. 앨리어싱, 절단 모드, 기하 구조, 정규화, 훈련 해상도 범위를 확인해야 한다. 표준 FFT 기반 FNO는 규칙 격자와 주기 표현에서 특히 자연스럽고 불규칙한 기하 구조에는 추가 설계가 필요하다.
9. PINN과 신경 연산자를 같은 축으로 비교하기
무엇을 학습하는가
- PINN: 주로 특정 PDE 사례의 좌표-해 함수
- 신경 연산자: PDE 사례 계열에 대한 입력 함수-해 함수 사상
어떤 학습 신호가 필요한가
- PINN: 지배 방정식, 초기 조건과 경계 조건, 선택적으로 희소 관측값
- 신경 연산자: 여러 사례의 짝지은 입출력 장이 중심이며 물리 손실을 추가할 수 있음
훈련 뒤 무엇을 얻는가
- PINN: 그 사례에 맞게 최적화된 해 근사
- 신경 연산자: 훈련 분포와 관련된 새로운 입력 함수에 반복 쿼리할 모형
주요 비용은 어디에 있는가
- PINN: 새 사례마다 다시 최적화해야 하는 경우가 많음
- 신경 연산자: 짝지은 해 데이터셋 생성과 사전 훈련 비용이 큼
무엇과 비교해야 하는가
- 동일 허용오차와 하드웨어 조건의 수치 풀이법
- 축소 차수 모형
- 문제에 맞는 고전적 대리 모델
- 데이터 전용 신경망과 물리 정보 기반 변형의 절제 실험
이 비교는 고정된 법칙이 아니다. 매개변수형 PINN, 물리 정보 신경 연산자처럼 경계를 섞는 방법이 있다. 논문에서는 이름이 아니라 실제 입력, 출력, 목적 함수, 재학습 조건을 확인한다.
10. 평가 설계
PDE 모형은 점별 평균 오차만으로 판단하지 않는다.
- 상대 \(L^2\) 오차와 관심 물리량의 오차
- 초기 조건과 경계 조건 만족
- 보존 오차와 장시간 안정성
- 새로운 계수, 강제항, 기하 구조, 해상도에 대한 OOD 성능
- 훈련과 추론을 포함한 실제 경과 시간 비용
- 수치 풀이법의 허용오차와 격자망 수렴
- 여러 난수 초깃값과 실패 비율
잔차 손실은 훈련 목적 함수이고 해 오차는 평가 물리량이다. 둘을 같은 것으로 취급하지 않는다. 기준 해도 이산화 오차를 가지므로 충분히 수렴한 수치 풀이법 설정과 출처 이력이 필요하다.
이 장에서 기억할 내용
- 표준 PINN은 좌표에서 해 값으로 가는 신경망을 특정 PDE 사례에 맞게 최적화한다.
- 신경 연산자는 여러 사례를 통해 함수-함수 사상을 학습한다.
- PINN은 방정식 잔차를 쓴다는 사실만으로, 신경 연산자는 연산자를 학습한다는 사실만으로 정확성과 일반화가 보장되지 않는다.
- 두 방법 모두 기존 수치 풀이법, 전체 비용, 실제 OOD 조건과 비교해야 한다.
이름과 위치만 알아둘 내용
- 약형 또는 변분 PINN
- 영역 분할과 XPINN
- 적응형 콜로케이션 점 샘플링
- 물리 정보 신경 연산자
- 그래프 또는 기하 인식 신경 연산자
- 스펙트럼 방법과 앨리어싱
- 연산자 학습의 근사 이론
자주 하는 혼동과 한계
자주 생기는 혼동과 한계
PINN은 데이터가 필요 없는가
방정식, IC, BC가 학습 신호가 될 수 있어 짝지은 해 데이터가 없어도 구성할 수 있다. 하지만 콜로케이션 점과 정확한 방정식 정보가 필요하고, 역문제나 잡음이 섞인 관측값에서는 데이터가 들어갈 수 있다.
신경 연산자는 PDE를 몰라도 되는가
짝지은 데이터만으로 학습할 수 있는 설정도 있지만 데이터는 보통 PDE 수치 풀이법에서 생성된다. 문제 범위, 경계 조건, 이산화를 모르면 데이터와 일반화 범위를 해석하기 어렵다.
PINN이 수치 풀이법을 일반적으로 대체하는가
아니다. 문제 범주, 정확도, 차원, 반복 쿼리 여부에 따라 기존 수치 풀이법이 더 빠르고 신뢰성 높을 수 있다. 반드시 통제된 기준 모델을 둔다.
다른 해상도에서 실행되면 격자망에 무관한가
아니다. 모형 구조가 다른 이산화의 입력을 받을 수 있다는 것과 정확도가 유지된다는 것은 다르다. 훈련 범위 밖 해상도와 기하 구조에서 직접 검증해야 한다.
물리 정보 기반이라는 이름이면 보존을 보장하는가
잔차 벌점은 제약 위반을 줄이려는 연성 제약일 수 있다. 정확한 보존이나 경계 조건 충족이 필요하면 모형 구조와 수치 구성을 확인해야 한다.
앞뒤 장과의 연결
- 2장: PINN은 자동미분으로 좌표 도함수를 계산한다.
- 3장: 여러 손실 항의 크기와 기울기 충돌이 최적화를 어렵게 만든다.
- 5장: FNO의 스펙트럼 합성곱을 CNN의 국소성과 비교할 수 있다.
- 8장: 불규칙 격자망을 그래프로 표현하는 연산자 모형이 가능하다.
- 13장: 배치 환경의 질문, 수치 기준 모델, OOD 분할, 전체 계산비용을 가져온다.
- 15장: MLIP는 PDE 해가 아니라 원자 규모 에너지와 힘을 학습하는 별도 문제다.
스스로 확인하기
- 표준적인 PINN과 신경 연산자는 각각 하나의 PDE 사례와 문제 계열 중 무엇을 주로 학습하는가?
- 방정식 잔차가 작다는 사실과 기준 해 오차가 작다는 사실을 구분해야 하는 이유는 무엇인가?
- 신경 연산자의 사전 훈련 비용은 어떤 사용 조건에서 이점으로 회수될 수 있는가?
- 다른 해상도를 입력할 수 있다는 사실과 해상도 일반화가 검증되었다는 주장은 어떻게 다른가?
더 읽을 자료
- Raissi, Perdikaris, and Karniadakis, Physics-informed neural networks, Journal of Computational Physics 2019: https://doi.org/10.1016/j.jcp.2018.10.045
- Lu et al., Learning nonlinear operators via DeepONet based on the universal approximation theorem of operators, Nature Machine Intelligence 2021: https://doi.org/10.1038/s42256-021-00302-5
- Li et al., Fourier Neural Operator for Parametric Partial Differential Equations, ICLR 2021: https://openreview.net/forum?id=c8P9NQVtmnO
- Krishnapriyan et al., Characterizing possible failure modes in physics-informed neural networks, NeurIPS 2021: https://proceedings.neurips.cc/paper/2021/hash/df438e5206f31600e6ae4af72f2725f1-Abstract.html
원전을 읽을 때 모형 구조 그림만 보지 말고 각각 몇 개의 PDE 사례를 학습하는지, 기준 해는 어떻게 만들었는지, 새 사례마다 최적화하는지를 확인한다.